
Guia
Por que o reconhecimento de texto erra palavras, e como resolver
O reconhecimento de texto (OCR) lê palavras erradas principalmente por causa da imagem, não do texto: borrão, sombras, uma página inclinada ou curva, letras pequenas demais na moldura ou um idioma que o OCR não reconhece. Corrija o escaneamento e o texto costuma se corrigir sozinho: escaneie de novo com luz uniforme, segure o iPhone reto e perto, corte as bordas escuras e confira se o Texto ao Vivo aceita o idioma. Depois pesquise uma palavra que você está vendo para testar.

O reconhecimento de texto, ou OCR, é o que transforma a imagem de uma página em texto que você pode pesquisar, copiar ou ouvir em voz alta. Quando funciona, você nem percebe. Quando não funciona, a busca por “fatura” não acha nada, o texto copiado diz “faiura” e um total de 1.050 vira 1.O5O. Esta página explica por que isso acontece e o que mudar. Para páginas em árabe, hebraico, japonês e outras escritas, veja reconhecimento de texto em outros idiomas, que trata do suporte a idiomas em detalhe.
Os erros que você vai ver
Os erros de OCR seguem padrões. Conhecê-los facilita enxergá-los.
| Impresso | Muitas vezes lido como | Por quê |
|---|---|---|
| rn | m | As duas letras se encostam em uma imagem desfocada |
| 0 (zero) | O (letra) | Mesmo formato em muitas fontes |
| 1, l, I | Qualquer um dos outros | Traços verticais finos |
| 5, 8, 6 | S, B, b | Formas arredondadas se confundem com o borrão |
| é, ü, ñ | e, u, n | Os acentos são minúsculos e somem |
| Duas colunas | Linhas misturadas de lado a lado | Ordem de leitura errada |
| Uma tabela | Números nas linhas erradas | As bordas das células confundem o layout |
| Uma palavra dividida na quebra de linha | Duas meias palavras | Hifens e finais de linha |
O problema costuma ser a imagem
Quem cria mecanismos de OCR diz sempre a mesma coisa: dê ao mecanismo uma imagem melhor. A documentação do Tesseract, um mecanismo de OCR de código aberto muito usado, lista os problemas de imagem que reduzem a precisão. Eles valem para qualquer OCR, inclusive o que o seu iPhone usa.
Pequena ou desfocada demais
A documentação do Tesseract diz que ele funciona melhor com imagens de pelo menos 300 dpi. Fabricantes de software de escaneamento também recomendam cerca de 300 dpi para documentos impressos comuns e avisam que 75 dpi só serve para uma prévia. O celular não tem ajuste de dpi, mas a ideia se mantém: as letras precisam de pixels suficientes. Solução: segure o iPhone perto o bastante para a página preencher a tela, fique parado e deixe-o focar. Fotografar uma mesa inteira em pé dá letras pequenas e desfocadas. Se o escaneamento está borrado, por que os escaneamentos saem borrados traz as soluções.
Sombras e luz irregular
O OCR primeiro decide quais pixels são tinta e quais são papel. A documentação do Tesseract observa que essa etapa pode falhar quando o fundo da página tem escuridão irregular, que é exatamente o que uma sombra ou uma lâmpada em um canto causam. As letras na sombra se fecham; as letras no reflexo somem. Solução: luz do dia perto de uma janela, seu corpo fora do caminho entre a luz e a página, sem flash em papel brilhante. Veja como remover sombras de escaneamentos.
Uma página inclinada ou curva
Segundo a documentação do Tesseract, a detecção de linhas piora muito quando a página está inclinada, e isso afeta severamente o resultado. Uma página fotografada em ângulo, ou uma página de livro que se curva na lombada, dá linhas tortas e curvas. Solução: escaneie com um escâner (Notas, Arquivos, Pré-Visualização ou um app), que encontra as bordas e endireita a página, em vez de uma foto comum. Pressione as páginas de livro para deixá-las planas.
Bordas escuras e sujeira
Páginas escaneadas costumam ter bordas escuras, e a documentação do Tesseract observa que elas podem ser lidas como caracteres a mais. Furos de perfurador, grampos, carimbos e escrita à mão nas margens fazem o mesmo. Solução: corte até o papel.
Letra fraca, fina ou muito grossa
Traços finos e serifas perdem detalhe, e tinta muito pesada borra as letras umas nas outras. Recibos desbotados e fotocópias antigas são o pior caso. Solução: um filtro cinza costuma preservar texto fraco que um filtro forte de preto e branco descarta. Se o original está desbotado, escaneie agora, antes que desbote mais.
O idioma errado, ou sem suporte ao idioma
O OCR lê com um idioma em mente: as letras e o dicionário dele. O Texto ao Vivo da Apple “não está disponível em todas as regiões ou idiomas”. Uma página em um idioma que o OCR não aceita sai como texto sem sentido ou como nada. Solução: em Ajustes, Geral, Idioma e Região, confira se o Texto ao Vivo está ativado, e veja o guia de outros idiomas.
Escrita à mão
A escrita à mão é o caso mais difícil de todos, e erros são normais até em um escaneamento perfeito. Veja como converter escrita à mão em texto para saber o que esperar.
Teste o texto antes de confiar nele
- Abra o PDF escaneado e pesquise uma palavra que você vê claramente na página, de preferência uma incomum.
- Teste também um número, como o total de uma fatura.
- Se a busca não achar nada, o PDF pode não ter camada de texto. Nosso verificador gratuito de PDF pesquisável diz isso no seu navegador.
Para adicionar texto a um PDF que não tem nenhum, abra-o na Pré-Visualização, toque no botão de ações, toque em Exportar, escolha PDF e ative Integrar Texto. A Apple diz que isso faz o OCR das imagens e torna o PDF pesquisável. Há mais formas em como tornar um PDF escaneado pesquisável.
Quando não dá para escanear de novo
Às vezes o original sumiu e tudo que você tem é um escaneamento ruim.
- Copie o texto e corrija-o em um documento, conferindo com a imagem.
- Pesquise parte de uma palavra (“atura” em vez de “fatura”) para achar páginas em que a primeira letra foi lida errado.
- Digite os dados principais (total, data, número da conta) no nome do arquivo ou em uma nota, para encontrá-lo independentemente do OCR.
Onde o Scanner One ajuda, e onde não
Os escâneres da Apple e o Integrar Texto da Pré-Visualização se saem bem com texto impresso limpo. Se a busca acha suas palavras, o seu texto está bom.
O Scanner One age sobre as causas acima na etapa do escaneamento. O Scanner One encontra as bordas da página automaticamente e corrige a perspectiva. Livros abertos são divididos em duas páginas, e as linhas curvas são endireitadas. Os escaneamentos têm os filtros Autolimpeza, Cor, Cinza e Recibo. O filtro Recibo transforma um recibo apagado em texto preto nítido sobre branco. O reconhecimento de texto acontece no próprio aparelho, em 29 idiomas. O reconhecimento de texto funciona em todas as páginas para todos, no Grátis ou no Pro.
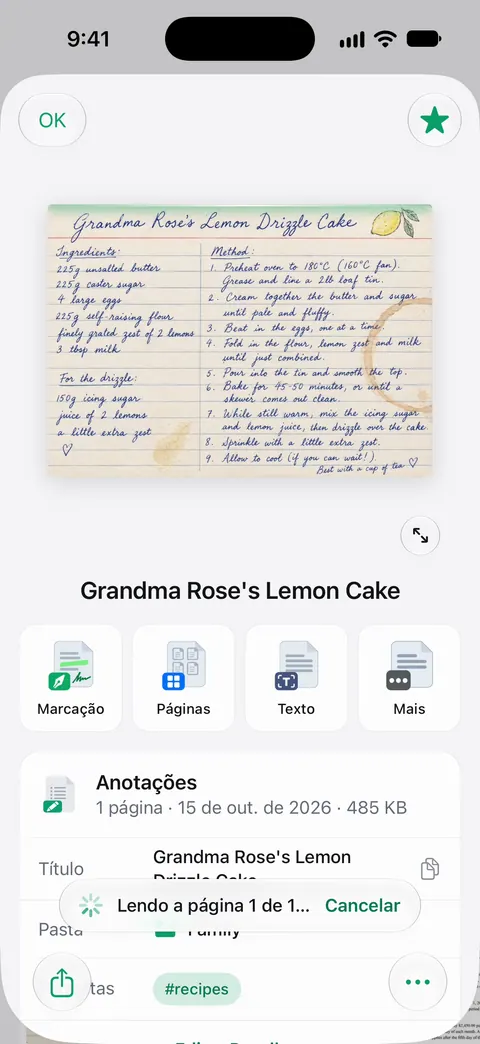
A busca procura dentro do texto de todos os documentos e mostra a linha e a página encontradas. Isso facilita testar um escaneamento pesquisando uma palavra que você está vendo.
Os limites, em termos claros:
- Nenhum OCR é perfeito. Texto desbotado, letras minúsculas, tabelas e escrita à mão ainda geram erros, então confira os números que importam.
- Editar diretamente as palavras de um escaneamento é um recurso do Pro: O Pro adiciona tarjas, a borracha inteligente, a edição de texto, a exportação automática e cinco ícones alternativos para o app.
- O Scanner One é grátis, com limites generosos: escanear, gerar PDFs limpos e buscar no texto nunca param.
O verbete do glossário sobre OCR explica o próprio termo.
Perguntas e respostas
Qual é a precisão do OCR?
Em um escaneamento nítido e reto de texto impresso limpo, é muito precisa. A precisão cai rápido com borrão, sombras, letras pequenas ou desbotadas, fontes incomuns, tabelas e escrita à mão. Nenhum OCR acerta sempre, então confira nomes e números em tudo que for importante.
Que resolução preciso para um bom OCR?
A documentação do OCR Tesseract diz que ele funciona melhor com imagens de pelo menos 300 dpi. No celular, isso significa preencher a moldura com a página e ficar parado, em vez de fotografar de longe e ampliar.
Posso corrigir erros de OCR em um PDF escaneado?
A camada de texto escondida geralmente não pode ser editada à mão em um app de PDF comum. A solução prática é escanear melhor e rodar o reconhecimento de novo, ou copiar o texto e corrigi-lo em um documento.
Por que o OCR mistura colunas e tabelas?
Ele precisa adivinhar a ordem de leitura. Duas colunas lado a lado podem ser lidas de ponta a ponta, e as células de uma tabela podem se misturar. Escanear uma coluna de cada vez, ou recortar uma tabela só, ajuda.
Fontes
O que esta página diz sobre o Scanner One foi conferido no app em .
- Tesseract documentation, Improving the quality of the output — como a resolução (pelo menos 300 dpi), fundos irregulares, ruído, inclinação, bordas e letras finas ou muito grossas reduzem a precisão do OCR no mecanismo de código aberto Tesseract; sem data, lido em 2026-11-13
- Hamrick Software, What is the best dpi for scanning documents? — cerca de 300 dpi bastam para um documento impresso comum; 75 dpi é pouco para quase tudo além de uma prévia; atualizado em 2022-07-01
- Interaja com o conteúdo de uma foto ou vídeo no iPhone — ativar o Texto ao Vivo em Idioma e Região; o Texto ao Vivo não está disponível em todas as regiões ou idiomas; página de guia sem data, lida em 2026-11-13
- Exporte ou comprima PDFs e imagens no app Pré-Visualização no iPhone — Integrar Texto faz o OCR das imagens de um PDF e o torna pesquisável; página de guia sem data, lida em 2026-11-13
- Scanner One na App Store — a ficha do próprio app: reconhecimento de texto no aparelho, filtros, detecção de bordas
Baixe o Scanner One
O Scanner One é grátis, com limites generosos: escanear, gerar PDFs limpos e buscar no texto nunca param.

Scanner OneEscaneie, assine e pergunte
O Scanner One é grátis, com limites generosos: escanear, gerar PDFs limpos e buscar no texto nunca param.